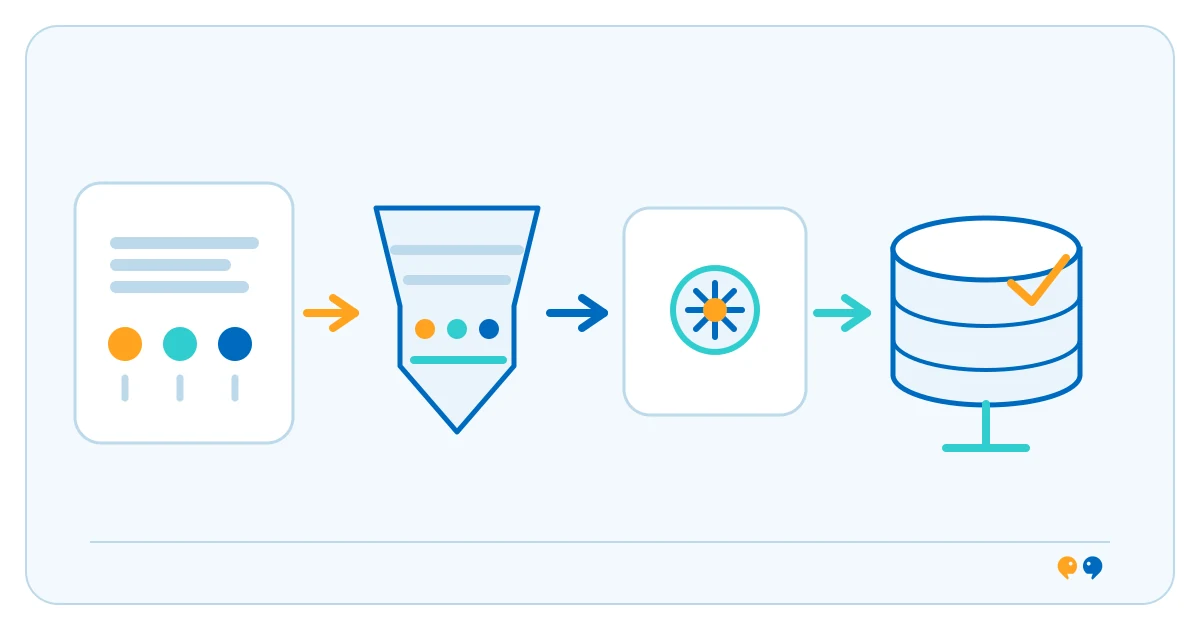
数据管道是一系列可重复的步骤,用于采集或搬运数据、处理数据,并将结果传送到指定位置。步骤可以包括验证、筛选、合并、转换格式或汇总。目标位置可以是报表存储、分析工具或另一个应用。AWS 将数据管道描述为准备企业数据以供分析的一系列处理步骤;数据管道也可以服务于运营流程。
数据管道如何工作
管道从一个或多个来源读取资料,根据定义好的规则进行转换,再写入目标位置。它可以按计划批量运行,也可以持续处理新事件。团队需要明确来源延迟、数据验证失败或流程中途停止时该如何处理。AWS 数据管道概览介绍了常见组件、批处理和流式处理方式,以及数据管道与 ETL 的关系。
企业应用示例
以下示例仅用于说明:运营报表可以整合排班系统中的服务记录和库存系统中的零件用量。管道将日期和标识转换为统一格式,标记无法匹配的记录,再把整理后的数据加载到报表中。如果不同来源的数值相互矛盾,仍需要员工判断以哪个来源为准。
数据管道、ETL 和系统集成
ETL 指提取、转换和加载,是搬运及整理数据的一种常见方法。其他管道可以先加载原始资料再进行转换,也可以持续传输数据变化。系统集成常用于应用间的运营数据交换;分析管道则通常将资料整理好供分析使用,两者也可能重叠。可阅读系统集成说明和RAG 的数据来源。
限制与运营需要
如果没有明确规则,管道无法自行判断来源数据的冲突意味着什么。即使流程顺利完成,字段映射错误、数据定义不一致或记录缺失,也会让结果产生偏差。应保护敏感数据,验证重要字段,监测数据更新时间和失败运行,并安排人员调查问题。批处理和流式处理的选择会影响数据到达速度和运营方式。
如需了解服务范围,可以查看 technine.io 的数据分析与 AI 可用数据服务。
常见问题
所有数据管道都是 ETL 吗?
不是。ETL 是一种处理方法;有些管道会先加载数据再转换,也可以持续处理事件或加入其他步骤。
批处理和流式处理有什么区别?
批处理会按间隔处理一组数据;流式处理则持续或分小批处理新事件。具体选择取决于数据需要多及时以及运营要求。
使用管道能保证数据干净吗?
不能。管道可以按照规则验证和转换数据,但规则必须符合已确认的定义。还要监测异常,并检查来源资料是否完整、可信。
主要资料来源:AWS:What is a data pipeline?