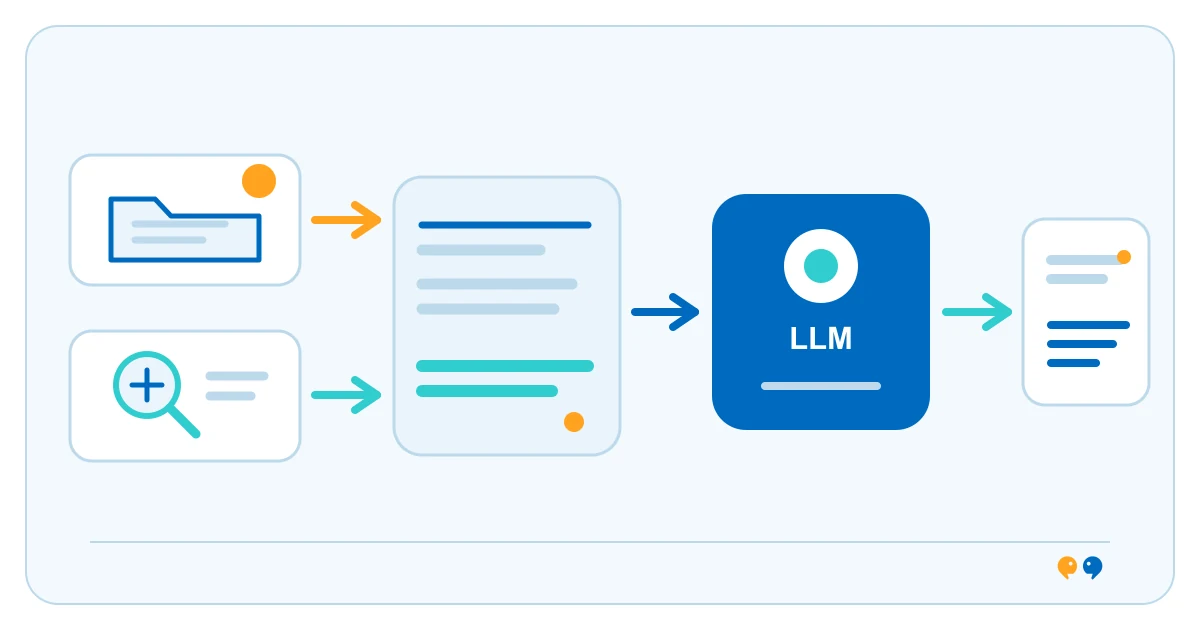
检索增强生成(RAG)会先从外部资料源找出相关内容,再交给语言模型参考并生成回答。这种方法将检索与文本生成结合起来,让响应能够使用模型参数之外的指定资料。RAG 的原始研究论文将这种方法描述为让模型访问明确的非参数记忆。
RAG 如何工作
系统先整理资料以便搜索,常见做法是把文档拆分成段落并建立索引。收到问题后,检索流程会搜索可能相关的内容。应用程序把问题和选出的段落交给语言模型,由模型起草回答;有些系统还会显示资料来源。每个环节都会影响结果,包括文档权限、索引、搜索、段落选择以及给模型的指令。
企业应用示例
以下示例仅用于说明:内部政策助手可以搜索一组已批准的现行流程文档,并附上找到的段落链接,起草回答。遇到特殊情况时,员工先核对原文再采取行动。这是一种可能的系统设计,并非经过衡量的成效。
RAG、模型训练和 AI 智能体
RAG 会在收到请求时提供相关资料;微调通过额外训练改变模型参数,预训练则让基础模型学习广泛模式。因此,RAG 不会训练模型的新参数;更新资料库也不代表每次回答都会引用最新或正确的段落。AI 智能体可以把 RAG 作为一种工具,但仅有检索并不等于智能体。可阅读什么是 LLM和AI 智能体如何工作。
RAG 的限制
如果来源文档缺失、过时或彼此矛盾,RAG 无法让资料变得可靠。搜索可能找到无关段落,模型也可能误解内容,或生成来源并未支持的说法。显示引用有助于核对资料来源,但不能证明回答完整或正确。企业应控制可搜索的来源,及时维护内容,测试常见问题,并在证据不足时明确提示。
如需了解服务范围,可以查看 technine.io 的企业 RAG 与知识系统服务。
常见问题
RAG 会训练 AI 模型吗?
不会。RAG 会检索外部资料,并在生成响应时将其作为参考。微调则通过额外训练更新模型参数。
RAG 能消除 AI 幻觉吗?
不能。相关资料可以为回答提供依据,但检索或理解仍可能出错。系统仍需评估、管理资料来源,并根据用途安排审核。
RAG 一定会显示引用吗?
不一定。系统可以检索文档,但不向用户展示。是否显示引用取决于应用程序设计;读者应能打开来源核对内容。
主要资料来源:Lewis 等人:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks