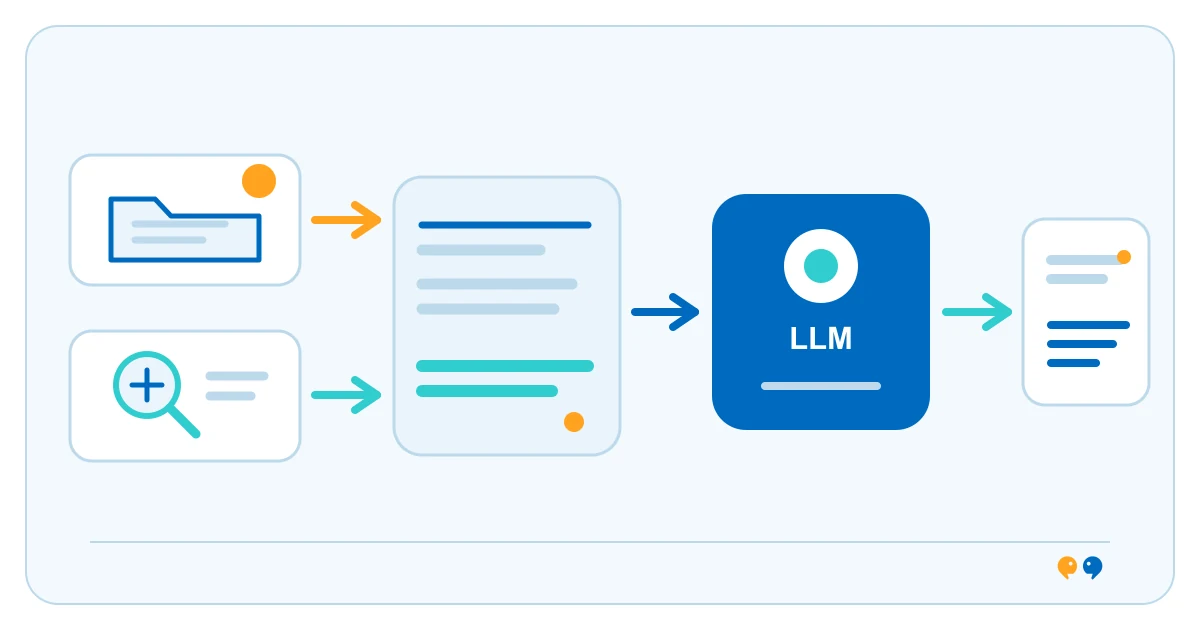
檢索增強生成(RAG)會先從外部資料來源找出相關內容,再交給語言模型參考並生成答案。這種方法把檢索和文字生成結合起來,讓回應可以運用模型參數以外的指定資料。RAG 的原始研究論文把這種做法描述為讓模型存取明確的非參數記憶。
RAG 如何運作
系統先整理資料以供搜尋,常見做法是把文件分成段落,再建立索引。收到問題後,檢索程序會搜尋可能相關的內容。應用程式把問題和選出的段落交給語言模型,由模型草擬回應;部分系統亦會顯示參考來源。每個環節都會影響結果,包括文件權限、索引、搜尋、段落選取,以及給模型的指引。
企業應用示例
以下示例僅供說明:內部政策助手可以搜尋一組已批准的現行程序文件,並附上找到的段落連結,草擬答案。遇到特別個案時,員工先核對原文再採取行動。這是可能的系統設計,並非經量度的成效。
RAG、模型訓練和 AI 代理
RAG 會在收到要求時提供相關資料;微調則透過額外訓練改變模型參數,預訓練則讓基礎模型學習廣泛模式。因此,RAG 不會訓練模型的新參數;更新資料庫也不代表每次回答都會引用最新或正確的段落。AI 代理可以把 RAG 當成一項工具,但單有檢索並不等於代理。可參閱甚麼是 LLM和AI 代理如何運作。
RAG 的限制
如果來源文件欠缺、過時或互相矛盾,RAG 無法令資料變得可靠。搜尋可能找到不相關段落,模型也可能誤解內容,或生成來源未有支持的說法。顯示引用有助核對資料來源,但不能證明答案完整或正確。企業應控制可搜尋的來源、定期更新內容、測試常見問題,並在證據不足時清楚提示。
如需了解服務範圍,可參閱 technine.io 的企業 RAG 及知識系統服務。
常見問題
RAG 會訓練 AI 模型嗎?
不會。RAG 會檢索外部資料,並在生成回應時把資料當作參考。微調則透過額外訓練更新模型參數。
RAG 可以杜絕 AI 幻覺嗎?
不能。相關資料可以為答案提供依據,但檢索或理解仍可能出錯。系統仍需評估、來源管理,以及配合用途的覆核安排。
RAG 一定會顯示引用嗎?
不一定。系統可以檢索文件,但不向用戶展示。是否顯示引用取決於應用程式的設計;讀者應能開啟來源查核內容。
主要資料來源:Lewis 等人:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks