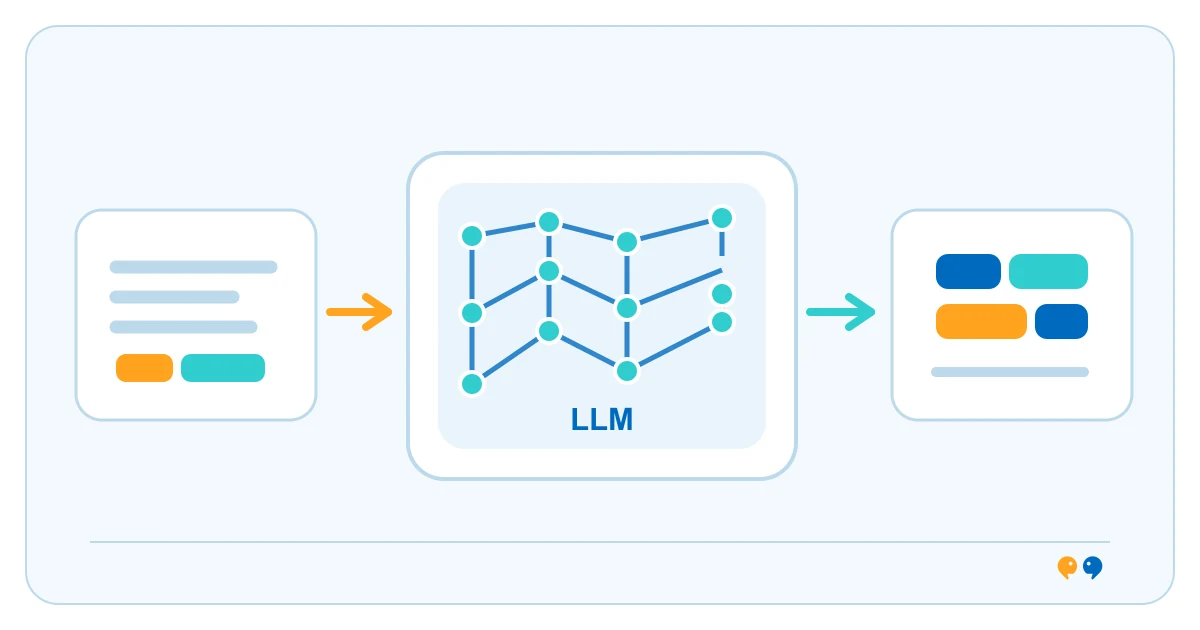
大型語言模型(LLM)是經大量資料訓練、用來處理和生成語言的機器學習模型。收到問題或草稿等輸入後,模型會生成可能的後續文字或改寫內容。視乎模型和應用程式,LLM 可協助摘要、起草、分類和回答問題。Google Cloud 的生成式 AI 詞彙表把 LLM 說明為以文字為主、透過大量資料訓練的基礎模型。
LLM 如何生成回應
應用程式把輸入交給模型,通常會一併提供指引和對話情境。模型把文字轉成 Token,按學到的模式和收到的情境生成內容。應用程式之後可以展示、檢查或轉送結果。有些模型也能處理其他形式的輸入,但功能因模型而異;LLM 不會自動讀取企業紀錄或連接互聯網。
企業應用示例
以下示例僅供說明:團隊可以用 LLM 草擬客戶服務對話摘要,再由員工對照原文,確認無誤後才加入個案紀錄。模型負責整理初稿;應用程式和員工決定提供哪些資料,以及下一步如何處理。
LLM、RAG 和 AI 代理
LLM 是處理和生成語言的模型。RAG 會檢索外部資料,再把資料交給模型參考。AI 代理則是較完整的應用程式,在任務流程中運用模型,並可能呼叫已設定的工具。模型本身不是資料庫、最新事實的可靠來源,也不是代理。可參閱RAG 解說和AI 代理解說。
需要留意的限制
LLM 可能用肯定語氣寫出錯誤、遺漏或沒有根據的內容。回應會受提示、情境、模型和系統設定影響。若應用程式沒有提供近期資料,模型未必掌握最新資訊;它也不會像業務負責人一樣理解規則。處理重要工作時,應提供合適來源、測試任務、保護敏感資料,並在採取行動前覆核結果。
如需了解服務範圍,可參閱 technine.io 的AI 及智能系統服務。
常見問題
向 LLM 提問時,它會搜尋互聯網嗎?
模型本身不會。產品可以把模型連接到搜尋或其他資料來源,但要視乎應用程式及相關設定。
LLM 會用肯定語氣給出錯誤答案嗎?
有可能。文字流暢不代表內容正確。涉及決策或紀錄時,應核對原始資料。
LLM 就是 AI 代理嗎?
不是。LLM 是模型;代理則是在工作流程中使用模型,並可能運用已設定工具的應用程式或系統。
主要資料來源:Google Cloud:生成式 AI 詞彙表